Podcast-Aufnahme: Die Checkliste vor dem ersten Satz
Die meisten Podcast-Formate scheitern nicht am schwachen Konzept, sondern an einer Aufnahme, die klingt wie ein verstaubter Konferenzanruf aus dem Jahr 2009.
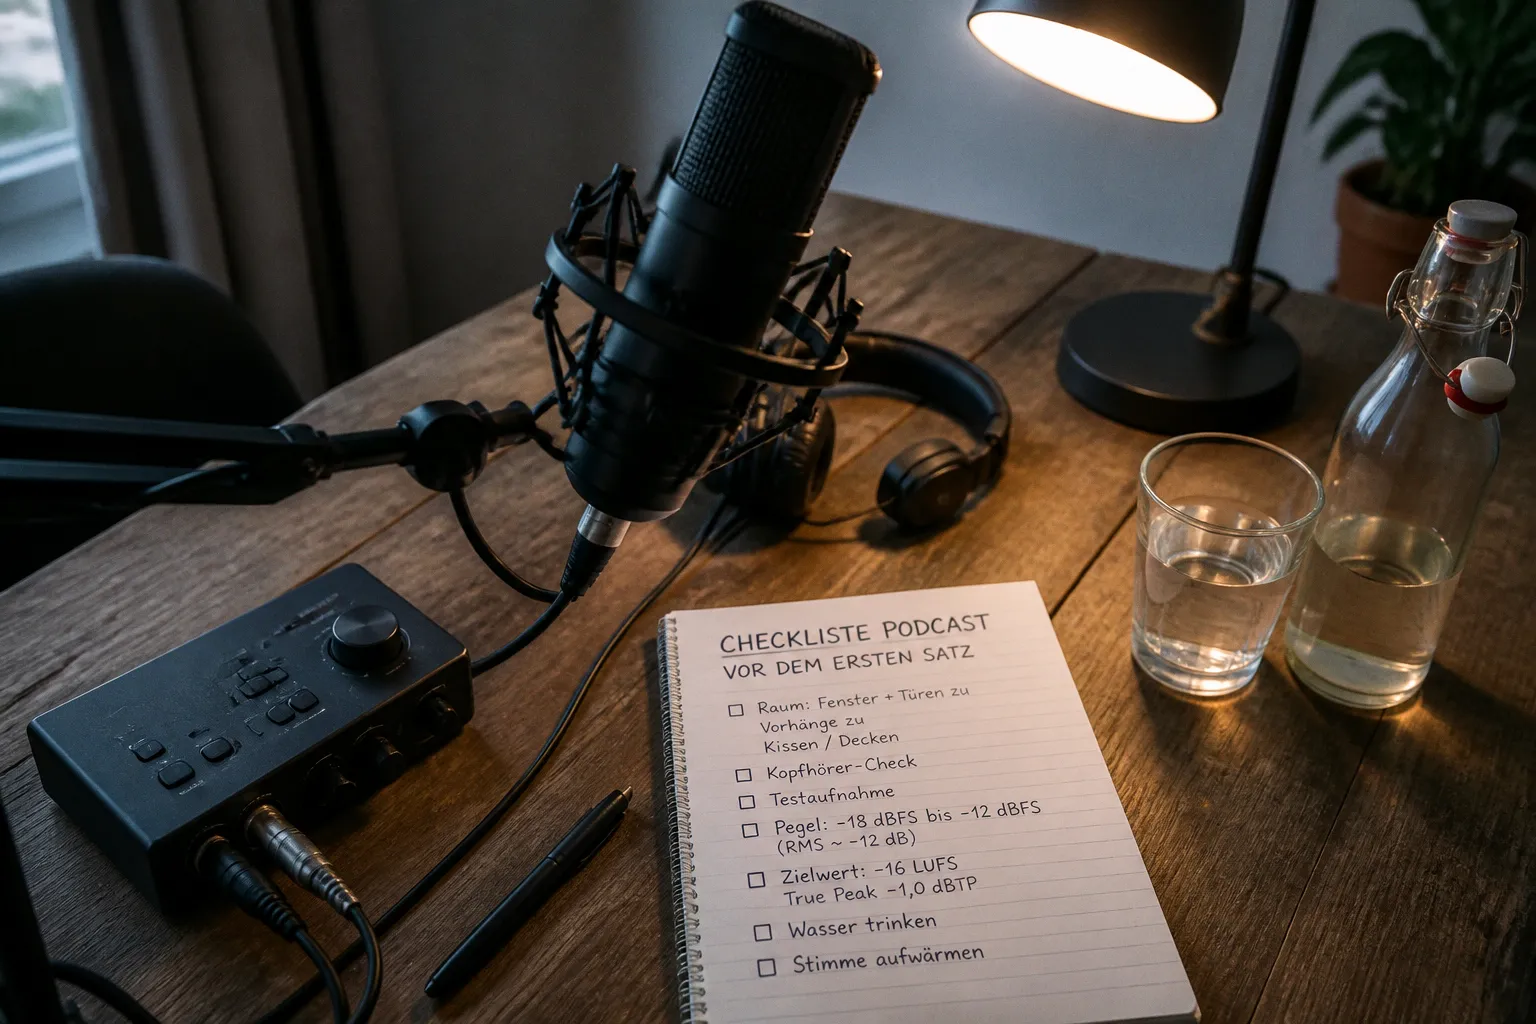
Wer glaubt, mit einem 800-Euro-Mikrofon in einem leeren, harten Großraumbüro professionelle Audioqualität zu erzeugen, hat das ökonomische Prinzip nicht verstanden: Der billigste Hebel in der gesamten Produktionskette liegt nicht im Equipment-Kauf, sondern in den zwanzig Minuten vor dem ersten gesprochenen Satz. Dort entscheidet sich, ob die Nachbearbeitung ein 45-minütiger Sumpf aus Noise-Reduction, EQ-Flickwerk und De-Essing wird – oder ein sauberer Schnitt, der in anderthalb Stunden durchläuft.
Diese Podcast-Aufnahme-Checkliste ist kein Romantik-Manual für Leidenschaft und Geschichten. Sie ist ein Produktionsfahrplan für Menschen, die aus Audio ein verlässliches Format machen wollen – mit planbarem Aufwand statt nur Sichtbarkeit. Wer den Ablauf der Podcast-Vorbereitung standardisiert, kauft sich keinen schöneren Klang auf Knopfdruck, sondern mehr Zeit, in der neuer Content entsteht, statt bereits aufgenommenes Material repariert zu werden.
Die entscheidenden Fehler passieren dabei selten während des eigentlichen Gesprächs. Sie entstehen vorher: im hallenden Raum, bei einem zu heiß eingestellten Preamp, mit trockener oder unvorbereiteter Stimme, einem nicht kontrollierten Signalweg oder einer Datei, die am Ende nicht sauber auf die Ausspielplattform passt. Eine gute Podcast-Aufnahme beginnt deshalb nicht mit dem roten Aufnahmeknopf. Sie beginnt mit einer kurzen, wiederholbaren Routine.
Akustische Optimierung des Aufnahmeumfelds: Den Raum bändigen
Bevor ein Kabel eingesteckt wird, gehört dem Raum die erste Aufmerksamkeit. Reflexionsflächen sind der stille Feind jeder Sprachaufnahme: Glas, Fliesen, blanke Wände, große Tischplatten und freistehende Regale mit harten Oberflächen. Schall kennt keine Romantik, sondern Physik. Hart reflektierende Flächen erzeugen frühe Reflexionen und Hall, der in der Nachbearbeitung nur mit hohem Aufwand und hörbaren Artefakten wieder eingedämmt werden kann.
Gerade Sprache verzeiht hier wenig. Ein Raum kann auf den ersten Eindruck ruhig wirken und trotzdem im Mikrofon unangenehm nachschwingen. Das Ohr gewöhnt sich an die Umgebung; das Mikrofon tut es nicht. Deshalb sollte die akustische Prüfung nicht vom Sitzplatz aus erfolgen, sondern direkt an der Position, an der gesprochen wird. Ein kurzes Klatschen, ein gesprochenes Wort oder eine Testaufnahme zeigen meist sofort, ob der Raum hart und blank klingt.
Die erste Korrektur braucht häufig kein spezielles Studiozubehör:
- Fenster und Türen schließen. Das reduziert Außenschall und verhindert zusätzliche Reflexionen aus angrenzenden Räumen. Vor der Aufnahme sollte außerdem klar sein, ob im Nebenraum Gespräche, Drucker, Waschmaschine oder Schritte zu erwarten sind.
- Vorhänge zuziehen. Stoff vor großen Glasflächen ist eine einfache Sofortmaßnahme. Dünne Dekorationsvorhänge helfen weniger als schwere, dicht fallende Stoffe, aber auch sie können die Härte des Raums reduzieren.
- Weiche Materialien nutzen. Kissen, Decken, offene Kleiderstapel oder ein Bett in der Nähe des Aufnahmebereichs schlucken einen Teil der Mittel- und Hochtonreflexionen. Wer sein Schlafzimmer zum Studio macht, liegt konzeptionell nicht falsch.
- Den Tisch nicht unterschätzen. Eine große, leere Platte kann Sprache zurück in das Mikrofon reflektieren. Eine textile Unterlage oder eine weichere Arbeitsfläche ist oft sinnvoller als ein zusätzlicher akustischer Aufsatz direkt am Mikrofon.
- Störgeräusche eliminieren. Lüftung, Klimaanlage, Ventilatoren und Benachrichtigungstöne sollten während der Aufnahme aus dem Signal verschwinden. Auch ein Kühlschrank oder ein Netzteil kann in leisen Passagen deutlich hörbar werden.
- Mikrofon nicht direkt an die Wand stellen. Ein kleiner Abstand zur nächsten harten Fläche hilft, frühe Reflexionen zu reduzieren. Noch wichtiger ist, dass die sprechende Person nicht mitten im Raum mit stark reflektierenden Flächen rundherum sitzt.
Wer in einem akustisch unbehandelten Raum aufnimmt, kauft sich Stunden an Nachbearbeitung, die im produzierten Content-Markt niemand bezahlt.
Das bedeutet nicht, dass jede Podcast-Produktion ein eigenes Studio braucht. Es bedeutet nur, dass der Raum als Teil der Aufnahmekette behandelt werden muss. Ein gutes Mikrofon kann die Eigenschaften eines schlechten Raums nicht aus dem Signal herauszaubern. Im Gegenteil: Ein empfindliches Mikrofon nimmt häufig noch genauer auf, was im Raum passiert.
Auch sogenannte Reflexionsfilter hinter dem Mikrofon werden gern überschätzt. Sie können in bestimmten Setups helfen, ersetzen aber keine sinnvolle Positionierung und keine weichen Flächen im Raum. Wer glaubt, ein 1.500-Euro-Studiodesigner-Regal ersetze ein Handtuch über dem Schreibtischmikrofon, hat die Wertschöpfungskette nicht verstanden. In kleinen Räumen ist eine kontrollierte, trockene Umgebung durch vorhandene Materialien fast immer billiger und oft wirkungsvoller als jedes beliebige Acoustic-Panel-Produkt aus dem Pro-Audio-Versandhandel.
Raumgeräusch von Sprachgeräusch trennen
Für die Testaufnahme gehört auch ein kurzer Abschnitt ohne Sprache in die Datei. Diese Pause ist kein verlorener Moment. Sie zeigt, ob ein Grundrauschen, ein Brummen oder ein rhythmisches Geräusch vorhanden ist. In einer Gesprächssituation mit mehreren Personen sollte jede Stimme einzeln geprüft werden, weil unterschiedliche Mikrofone und Sitzpositionen den Raum verschieden stark aufnehmen.
Wer remote aufnimmt, muss zusätzlich die technische Umgebung kontrollieren. Ein gutes Headset oder Mikrofon hilft nicht, wenn die Verbindung schwankt, das Betriebssystem die falsche Eingangsquelle wählt oder die Gesprächspartnerin über Lautsprecher zurück in das Mikrofon spielt. Eine Aufnahmeplattform ist nur so zuverlässig wie ihr Signalweg. Der Raum bleibt auch bei einer Online-Aufnahme relevant – nur verteilt er sich dann auf mehrere Orte.
Gain Staging und Pegel-Management: Die richtige Aussteuerung finden
Die größte Sünde ambitionierter Hobbyisten: Aufnahmepegel werden nach Gehör eingestellt – und damit fast immer falsch. Nach Gehör bedeutet in der Praxis häufig: digital übersteuert oder im Rauschen versteckt. Beides kostet.
Der ökonomische Hebel ist klar definiert: Aufnahmespitzenpegel zwischen etwa −18 dBFS und −12 dBFS, mit einem mittleren RMS-Bereich um −12 dB. Das ist kein ästhetischer Kompromiss, sondern eine Headroom-Reserve gegen Clipping. Wer näher an die digitale 0 dBFS spielt, riskiert eine Aufnahme, die sich nicht mehr retten lässt. Jeder Kompressor und jeder Limiter im Nachgang verstärkt das Artefakt, statt es zu glätten.
| Parameter | Zielwert | Konsequenz bei Missachtung |
|---|---|---|
| Spitzenpegel (Peak) | etwa −18 bis −12 dBFS | Clipping und digitale Verzerrung |
| Mittlerer Pegel (RMS) | ungefähr −12 dB | Leise Passagen verschwinden stärker im Rauschen |
| Headroom-Reserve | mindestens etwa 12 dB | Weniger Spielraum für Dynamikbearbeitung |
| Preamp-Gain | moderat, nicht am Maximum | Die Eigenrauschbasis des Interfaces tritt stärker hervor |
Drei Hebel funktionieren in praktisch jeder Aufnahmesession:
1. Den Preamp in zwei Schritten einpegeln. Zuerst mit normaler Lautstärke sprechen, anschließend eine besonders laute Passage aus dem geplanten Inhalt lesen. Der Gain wird so justiert, dass die lautesten Stellen im Zielbereich bleiben. Entscheidend ist nicht die durchschnittliche Gesprächslautstärke, sondern die lauteste realistische Silbe.
2. Atempausen und spontane Lautstärkespitzen mitprüfen. Ein Pegel, der bei einem ruhigen Intro funktioniert, kann bei Lachen, einem schnellen Einwurf oder einer betonten Aussage sofort zu hoch sein.
3. Die Stille zwischen den Sätzen beobachten. Wenn das Eingangsrauschen des Interfaces deutlich hörbar wird, liegt der Pegel möglicherweise zu niedrig – oder die Kombination aus Mikrofon, Raum und Interface passt nicht gut zusammen. Mehr Gain ist dann nicht automatisch die Lösung.
Die Lautstärke sollte nicht nur in der DAW-Anzeige, sondern auch an der tatsächlichen Sprechposition kontrolliert werden. Verändert sich der Abstand zum Mikrofon, verändert sich nicht nur der Pegel. Auch der Nahbesprechungseffekt, der Anteil von Raum und die Gewichtung einzelner Frequenzen können sich verschieben. Eine Person, die während einer Aufnahme ständig nach hinten kippt oder sich zum Bildschirm dreht, produziert deshalb nicht bloß schwankende Lautstärke, sondern eine wechselnde Klangfarbe.
Das Argument, ein teureres Interface erzeuge automatisch eine bessere Aufnahme, ist zu großen Teilen ein Mythos. Der hörbare Unterschied entsteht in vielen Setups zuerst durch Raumakustik, Mikrofonposition, Sprechabstand und Pegel-Management – nicht durch das letzte Bit Auflösung eines 24-Bit-Wandlers. Wer das nicht akzeptiert, kauft Features, die im Endprodukt niemand hört.
Pegel nicht mit Lautheit verwechseln
Der Eingangspegel ist nicht dasselbe wie die spätere Lautheit der fertigen Episode. Bei der Aufnahme geht es um ein sauberes, unverzerrtes Signal mit ausreichendem Spielraum. Erst in der Mischung und im Mastering wird entschieden, wie laut die fertige Datei wahrgenommen wird.
Ein lauter Kopfhörerausgang kann dabei zusätzlich täuschen. Wenn die eigene Stimme im Monitoring sehr präsent klingt, heißt das nicht, dass das Eingangssignal korrekt ausgesteuert ist. Monitoring-Lautstärke und Aufnahmepegel müssen getrennt betrachtet werden. Die Anzeige des Interfaces und die Meter in der DAW sind dafür verlässlicher als der subjektive Eindruck im Kopfhörer.
Stimmvorbereitung und physische Präsenz vor dem Mikrofon
Eine Sprechstimme ist ein Produktionswerkzeug. Sie hat Verschleiß, Zustände und Vorbereitungszeiten. Wer nach mehreren Tassen Kaffee und einer langen Reihe von E-Mails in die Aufnahme geht, produziert eine Stimme, die klingt wie das Meeting, das niemand haben wollte.
Die Stimme folgt keinen ästhetischen Moden, sondern einer Leistungskurve. Für die Vorbereitung zählt weniger ein kompliziertes Ritual als ein Zustand, in dem Atmung, Artikulation und Energie reproduzierbar sind:
- Ausreichend trinken. Stilles Wasser griffbereit zu haben, hilft gegen einen trockenen Mund und kann störende Mundgeräusche reduzieren. Kohlensäure kann bei manchen Menschen Aufstoßen begünstigen; sehr süße oder milchhaltige Getränke sind während einer längeren Sprachaufnahme ebenfalls nicht für alle angenehm.
- Eine kurze Aufwärmphase einplanen. Lautes Vorlesen, lockere Artikulationsübungen und einige Sätze aus dem Skript bringen Stimme und Sprechtempo in den richtigen Bereich. Fünf bis zehn Minuten reichen als praktikabler Anfang, wenn die Stimme nicht bereits belastet ist.
- Nicht sofort die wichtigste Passage aufnehmen. Ein kurzer Einstieg oder ein Probedurchlauf kann helfen, Tempo und Lautstärke zu finden. Die erste Minute klingt häufig anders als der Rest der Episode, weil die Stimme noch nicht im Arbeitsmodus ist.
- Aufrecht sitzen oder stehen. Beide Füße sollten stabilen Kontakt zum Boden haben. Eine zusammengesunkene Haltung erschwert die Atmung und macht den Klang oft enger. Das Mikrofon übersetzt diese körperliche Anspannung gnadenlos.
- Die Mikrofondistanz markieren. Ein fester Abstand schafft Konstanz. Je nach Richtcharakteristik und Kapsel liegt er meist zwischen 10 und 20 Zentimetern. Entscheidend ist nicht die magische Zahl, sondern dass sie während der Aufnahme möglichst stabil bleibt.
- Plosive nicht erst im Schnitt bekämpfen. Ein leicht seitlich versetztes Mikrofon, ein passender Abstand und ein Poppschutz sind häufig wirksamer als die spätere Reparatur einzelner Explosivlaute.
- Pausen zulassen. Sprechende versuchen oft, jede Lücke sofort zu füllen. Für den Schnitt sind kurze, natürliche Pausen jedoch wertvoller als ein durchgehend gehetzter Redefluss.
Eine unvorbereitete Stimme kann den Schnitt deutlich verlängern. Wie stark sich das auswirkt, hängt von Format, Länge, Sprecher, Aufnahmeumgebung und Schnittstil ab. Bei einer wöchentlichen Veröffentlichung können sich solche zusätzlichen Minuten und Stunden über ein Quartal spürbar summieren – als verlorene Produktionszeit oder als zusätzliche externe Schnittkosten. Eine seriöse Pauschalsumme lässt sich daraus nicht ableiten; der Effekt ist individuell.
Die kreative Eingebung auf Knopfdruck ist eine Geschäftsidee von Autoren, die nie eine Sendung liefern mussten. Wer einen Podcast als Produkt betreibt, professionalisiert die Stimmvorbereitung genauso wie das Skript. Das heißt nicht, jede Äußerung zu glätten. Im Gegenteil: Versprecher, Lachen und spontane Wendungen gehören oft zum Format. Nur sollten sie aus einer kontrollierten Aufnahme entstehen und nicht aus einem vermeidbaren körperlichen oder technischen Problem.
Technische Routine: Monitoring, Testaufnahme und Signalprüfung
Kreative Freiheit endet dort, wo das Signal unkontrolliert ist. Vor dem ersten gesprochenen Satz stehen drei technische Pflichten, die in keinem Workflow übersprungen werden sollten:
1. Kopfhörer-Monitoring prüfen. Geschlossene Kopfhörer sind für viele Sprachaufnahmen der praktikable Standard. Sie verhindern, dass das Wiedergabesignal in das Mikrofon überspricht, und liefern eine direkte Beurteilung des Eingangssignals. Offene Kopfhörer können angenehmer klingen, sind in einer empfindlichen Sprachaufnahme aber häufig die schlechtere Wahl.
2. Eine Testaufnahme machen. Dreißig Sekunden reichen in vielen Fällen. Die Sequenz sollte eine normale Passage, eine lautere Stelle und eine leisere Passage abdecken. Diese Datei wird nicht Teil der Episode, sondern dient der Pegel- und Klangprüfung.
3. Den Aussteuerungspegel verifizieren. Die Anzeige am Audio-Interface oder in der DAW muss während der Testaufnahme im Zielkorridor liegen. Lieber zweimal nachjustieren als einmal eine komplette Episode reparieren.
4. Das Routing kontrollieren. Die richtige Spur muss auf den richtigen Eingang zeigen. Eine leuchtende Aufnahmeanzeige beweist nicht, dass tatsächlich das gewünschte Mikrofon aufgezeichnet wird.
5. Dateipfad und Aufnahmemodus prüfen. Vor allem bei längeren Gesprächen sollte klar sein, wohin die Datei geschrieben wird und ob sie tatsächlich gespeichert wird. Eine lokale Sicherung ist sinnvoll, wenn die Produktionsumgebung das erlaubt.
| Prüfschritt | Zeitaufwand | Überspringen bedeutet |
|---|---|---|
| Kopfhörer-Monitoring | etwa 1 Minute | Übersprechen oder unbemerkte Signalprobleme |
| Testaufnahme | etwa 2–3 Minuten | Pegelfehler in der gesamten Episode |
| Pegel-Verifikation | etwa 1 Minute | Clipping oder unnötiges Rauschen |
| DAW-Eingangs-Routing | etwa 1 Minute | Stille Aufnahme trotz aktiver Aufnahmeanzeige |
| Speicherort und Dateiname | etwa 1 Minute | Verwechslung oder fehlende Datei nach der Session |
Was eine Testaufnahme abdecken muss: die lauteste Silbe, typischerweise ein plötzliches P, T oder K, die leiseste Passage mit Flüstern oder Atempause und mehrere Sekunden Raum ohne Sprache. So lassen sich Plosive, Eigenrauschen und Störgeräusche beurteilen, bevor sie sich durch die ganze Episode ziehen.
Bei Gesprächen mit mehreren Mikrofonen sollte außerdem jedes Signal einzeln abgehört werden. Ein Kanal kann auf dem Meter ausschlagen und trotzdem falsch verkabelt, phasenverkehrt oder stark verrauscht sein. Bei Remote-Aufnahmen kommt die Kontrolle der Gesprächsseite hinzu: Sind beide Stimmen getrennt aufgezeichnet? Werden Aussetzer sichtbar? Ist die lokale Spur vollständig oder verlässt sich die Produktion auf einen komprimierten Mischkanal?
Wer diesen Schritt als bürokratisch abtut, verwechselt Routine mit Misstrauen. Routine ist kein Hemmschuh der Kreativität, sondern ihre Versicherung gegen zufällige Verluste. Sie schafft einen kurzen Moment, in dem technische Probleme noch billig zu lösen sind. Nach einer einstündigen Aufnahme ist derselbe Fehler kein kleiner Handgriff mehr, sondern ein Produktionsproblem.
Eine Testaufnahme ist keine Verzögerung des Gesprächs. Sie ist der letzte günstige Zeitpunkt, an dem sich ein Fehler beheben lässt.
Standardisierung für Plattformen: Von LUFS-Werten bis True Peak
Nach der Aufnahme kommt der zweite unternehmerische Hebel: die Plattform-Norm. Wer glaubt, eine einmal gemasterte Datei laufe auf Apple Podcasts, Spotify und YouTube identisch, unterschätzt die Unterschiede bei Ausspielung und Lautheitsanpassung. Plattformen normalisieren Inhalte unterschiedlich oder wenden ihre Anpassung unter verschiedenen Bedingungen an. Wer den Zielwert ignoriert, kann auf einer Plattform leiser oder lauter wahrgenommen werden als erwartet.
Die relevanten Zielwerte für viele Podcast-Workflows sind:
- −16 LUFS Integrated als gängiger Zielwert für Stereo-Podcasts.
- −19 LUFS Integrated als gängiger Zielwert für Mono-Produktionen.
- −14 LUFS Integrated als Bezugswert, der im Zusammenhang mit Spotify häufig verwendet wird.
- True Peak maximal −1,0 dBTP, um Verzerrungen bei der späteren Wandlung und Wiedergabe zu vermeiden.
- Eine Loudness Range von etwa 3–5 LU als praktikabler Bereich für viele gesprochene Formate.
Diese Werte sind keine Einladung, jede Episode mit Gewalt auf eine Zahl zu drücken. Eine Messung über die gesamte Datei kann durch Musik, Trailer, Werbung, längere Pausen oder stark unterschiedliche Gesprächsanteile beeinflusst werden. Deshalb gehört zur Kontrolle auch die Frage, ob die Dynamik noch natürlich wirkt. Ein Podcast darf präsent und verständlich sein, ohne dass jede Silbe auf demselben Lautstärkeniveau liegt.
Plattformen wenden bei nicht konformen Dateien automatische Lautheitsanpassungen an und regeln Inhalte entsprechend herauf oder herunter. Wer auf einen passenden Zielwert mastert, behält die Kontrolle über den eigenen Workflow. Wer deutlich darüber oder darunter liegt, überlässt einen Teil der Klangästhetik einem Algorithmus, der nichts vom Inhalt und nichts vom Sprecher weiß.
Plattform-Standards sind keine Ästhetik-Debatte, sondern eine Schnittstellen-Spezifikation. Wer sie ignoriert, liefert minderwertige Ware an den Verteiler.
Bei der finalen Datei sollten mindestens diese Parameter kontrolliert werden:
| Parameter | Zielwert | Mögliche Folge bei Abweichung |
|---|---|---|
| Integrated LUFS | −16 für Stereo, −19 für Mono als gängige Zielwerte | Lautheitsanpassung durch die Plattform |
| True Peak | maximal −1,0 dBTP | Risiko für Verzerrungen bei der Wiedergabe |
| Loudness Range | etwa 3–5 LU für viele Sprachformate | Unruhige oder unnatürlich stark komprimierte Dynamik |
| Sample-Rate | 44,1 oder 48 kHz, passend zum Produktionsworkflow | Zusätzliche Umwandlungsschritte |
| Format | WAV oder verlustfreies FLAC für die Ablage | Weniger Spielraum bei späteren Exporten |
Mastering ist nicht die Reparaturstation
Die Schlussbearbeitung kann eine gute Aufnahme konsistenter machen. Sie kann moderate Pegelschwankungen ausgleichen, störende Frequenzen reduzieren und die Sprachverständlichkeit verbessern. Sie kann jedoch keinen schlechten Raum vollständig in einen guten Raum verwandeln und kein hartes Clipping zuverlässig zurückholen.
Dasselbe gilt für übertriebene Rauschunterdrückung. Ein Algorithmus kann konstantes Hintergrundrauschen abschwächen, aber bei zu aggressiver Einstellung entstehen schnell metallische oder pumpende Artefakte. Wenn die Stimme zwischen den Sätzen unnatürlich verändert klingt, ist die technische Korrektur bereits selbst zum Problem geworden.
Die beste Podcast-Aufnahme-Vorbereitung-Checkliste endet deshalb nicht erst beim Export. Sie beginnt mit der Frage, welche Fehler gar nicht erst in die Datei gelangen dürfen. Das ist weniger spektakulär als ein neues Mikrofon und deutlich wirksamer.
Skalierungsökonomie: Warum die Checkliste ein Geschäftsmodell ist
Viele Podcast-Produzenten rechnen mit Equipment-Kosten als größtem Brocken. Das ist eine Milchmädchenrechnung. Die relevanten Kostenblöcke pro Episode bestehen aus Vorbereitung, Aufnahme, Organisation, Schnitt, Mischung, Mastering und Veröffentlichung. Die Vorbereitung ist häufig der kleinere Teil des Zeitbudgets. Trotzdem entscheidet sie mit darüber, ob die Nachbearbeitung am unteren oder am oberen Ende dieses Aufwands landet.
Eine saubere Aufnahme spart nicht automatisch einen feststehenden Betrag. Sie kann jedoch unnötige Korrekturschleifen reduzieren: weniger Reparatur einzelner Plosive, weniger Nacharbeit an Raumrauschen, weniger Suche nach verwertbaren Takes und weniger Rückfragen an Gesprächspartner. Wie groß die Zeit- und Kostenersparnis ausfällt, hängt vom eigenen Stundensatz, dem Umfang der Nachbearbeitung, der Episodenlänge, der Veröffentlichungsfrequenz und der Disziplin im Aufnahmeprozess ab.
Bei regelmäßiger Veröffentlichung wird aus einem kleinen Fehler ein wiederkehrender Produktionsposten. Wenn jede Episode zusätzliche Korrekturen verlangt, summiert sich nicht eine allgemeingültige Euro-Summe, sondern vor allem gebundene Arbeitszeit. Wer selbst schneidet, verliert Zeit für Konzept, Redaktion und Akquise. Wer den Schnitt auslagert, bezahlt für vermeidbare Arbeit. Genau deshalb ist die Podcast-Episode-planen-Checkliste kein Verwaltungsinstrument, sondern Teil des Geschäftsmodells.
Ein standardisierter Ablauf muss dabei nicht steril sein. Er kann festlegen, dass der Raum geprüft, der Pegel getestet, die Stimme vorbereitet und die Datei kontrolliert wird. Innerhalb dieses Rahmens bleibt genug Platz für spontane Gespräche, Umwege und echte Reaktionen. Standardisiert wird nicht der Inhalt, sondern die Umgebung, in der der Inhalt zuverlässig entstehen kann.
Wer die Audioaufnahme vorbereiten will, ohne diesen Ablauf zu strukturieren, produziert Handwerk mit hohem Zufallsanteil. Wer ihn strukturiert, schafft eine belastbare Produktionsroutine. Der Markt bezahlt nicht jede zusätzliche Stunde, die in Reparatur verschwindet. Er bezahlt die Episode, die verständlich, konsistent und rechtzeitig veröffentlicht wird.
Die eigentliche Checkliste vor dem ersten Satz ist deshalb kurz, aber nicht oberflächlich: Raum beruhigen, Störquellen entfernen, Mikrofonabstand festlegen, Stimme aktivieren, Pegel mit realen Passagen prüfen, Monitoring und Routing kontrollieren und die spätere Ausspielung bereits bei der finalen Bearbeitung mitdenken. Der Wert liegt nicht im Abhaken selbst. Der Wert liegt darin, dass dieselbe Qualität nicht jedes Mal neu erkämpft werden muss.