Kompressor Einstellungen für Vocals: Die richtige Balance finden
Wer im Vocal-Mix noch mit einem Universal-Preset aus dem Internet arbeitet, verbrennt Zeit. Wer sich ausschließlich auf das Ohr verlässt und die Kennzahlen ignoriert, macht die Fehlersuche unnötig teuer.
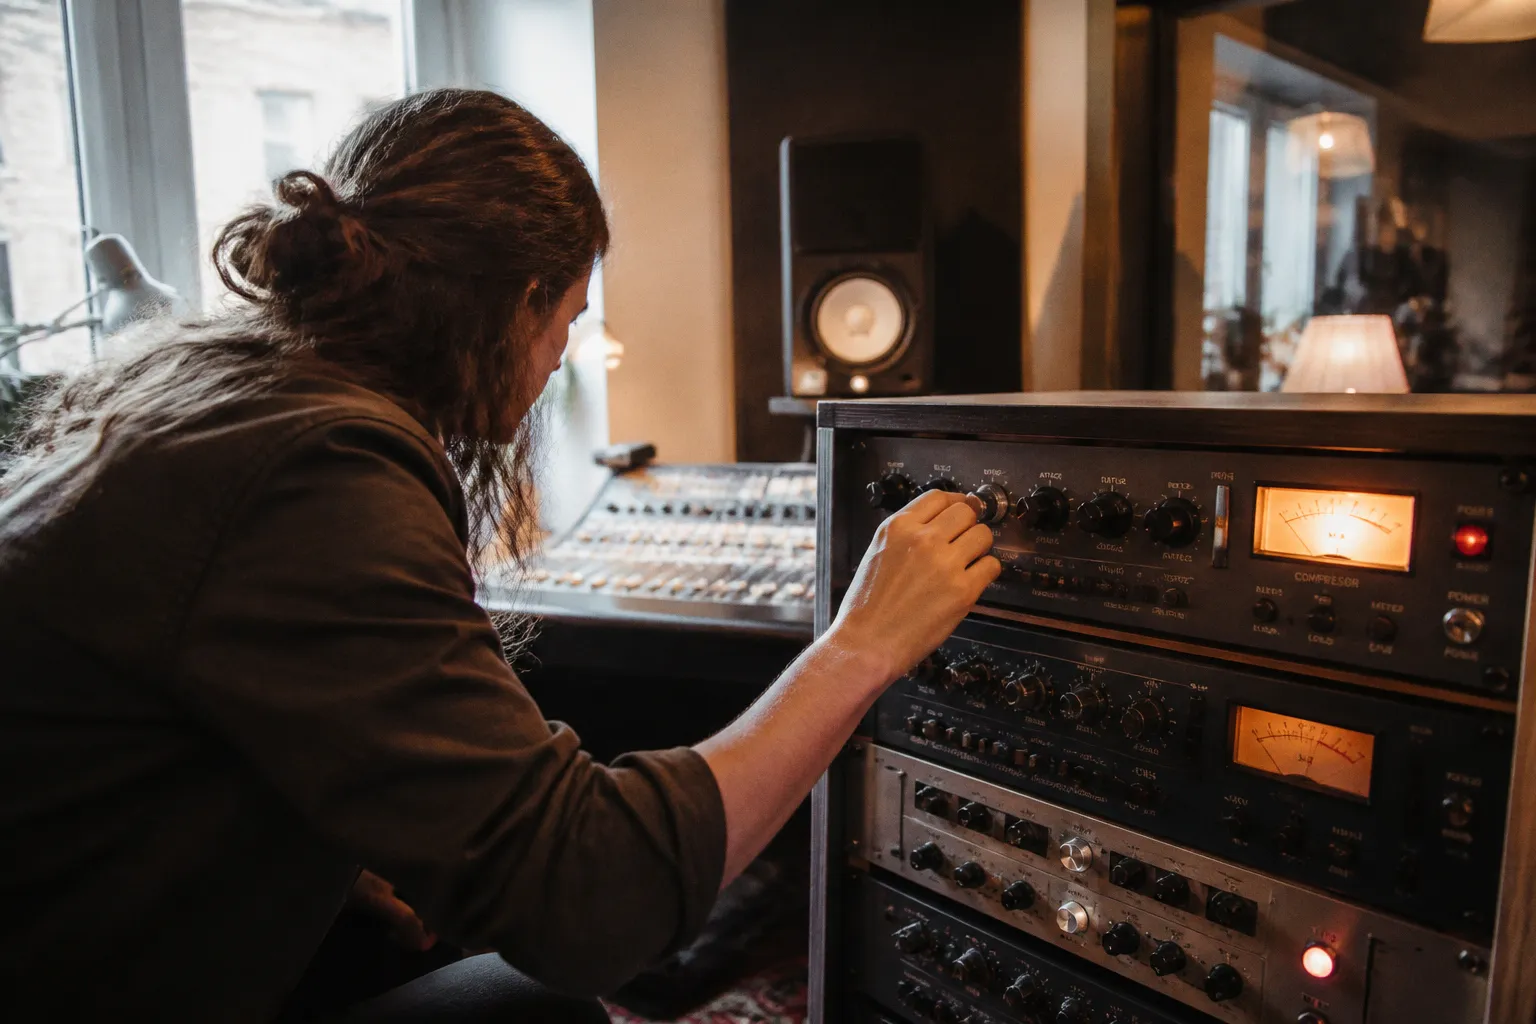
Die Kompression einer Gesangsspur ist keine Esoterik und kein Künstlergeheimnis, sondern ein technisches Optimierungsproblem mit klaren Stellgrößen. Es gibt keinen praktikablen Weg daran vorbei, diese Parameter zu verstehen, bevor man sie dreht. Wer eine Stimme so gut wie möglich zur Geltung bringen will, braucht zuerst ein funktionierendes Zusammenspiel aus Ratio, Threshold, Attack und Release. Ohne dieses Fundament bleibt jede Mischung ein Glücksspiel.
Dabei ist Kompression nicht automatisch gleichbedeutend mit mehr Qualität. Ein Kompressor kann eine Stimme im Arrangement stabilisieren, ihre Spitzen kontrollieren und leise Silben nach vorne holen. Er kann aber ebenso Atemgeräusche vergrößern, Zischlaute nach vorne schieben und eine natürliche Phrasierung plattmachen. Die richtige Einstellung entsteht deshalb nicht durch einen einzelnen Idealwert, sondern durch die Beziehung zwischen Stimme, Arrangement und gewünschter Wirkung.
Threshold und Ratio: Wo die Dynamik tatsächlich geknickt wird
Das eigentliche Geschäft der Vocal-Kompression findet an zwei Stellen statt: am Threshold und an der Ratio. Wer hier unsauber arbeitet, bekommt entweder eine Stimme, die sich im Mix versteckt, oder eine, die jede Emotion aus sich herauspresst.
Der Threshold legt fest, ab welchem Pegel der Kompressor überhaupt eingreift. Es gibt keinen universellen Zahlenwert, der für jede Aufnahme passt. Wer mit einem festen Wert wie −12 dB oder −18 dB arbeitet, ohne das Rohsignal zu kennen, schießt blind. Pegel der Gesangsaufnahme, Abstand zum Mikrofon, Raumanteil und Dynamik des Stücks bestimmen, wo der Threshold sitzen muss.
Als Einstiegspunkt kann die Gain-Reduction-Anzeige im Bereich von etwa 3 bis 6 dB pendeln. Das ist kein Qualitätsversprechen und kein Muss, aber ein brauchbarer Korridor für eine erste Verdichtung. Alles darüber sollte eine bewusste klangliche Entscheidung sein und nicht einfach die Folge eines zu niedrigen Thresholds. Bei sehr dynamischen Aufnahmen kann mehr Reduktion sinnvoll sein; bei einer bereits sauber kontrollierten Spur reichen mitunter deutlich kleinere Eingriffe.
Die Ratio entscheidet, wie stark der Kompressor oberhalb des Thresholds zupackt. Bei einer Ratio von 3:1 wird ein Signalanteil, der ohne Kompression 3 dB über dem Threshold läge, nur noch mit 1 dB über diesen Punkt hinausgelassen. Das Verhältnis beschreibt also nicht direkt die Stärke des gesamten Effekts, sondern die Steilheit der Pegelbegrenzung oberhalb des Einsatzpunktes.
Für Pop- und Rock-Vocals haben sich Verhältnisse von 3:1 bis 6:1 als typische Ausgangswerte etabliert. Niedrigere Werte zwischen 2:1 und 3:1 wirken transparenter und passen, wenn die Stimme bereits natürlich dynamisch aufgenommen wurde. Höhere Werte zwischen 5:1 und 6:1 erzeugen den dichten, nach vorne gerichteten Charakter, der in modernen Produktionen oft gefragt ist. Sie rauben der Stimme jedoch Agilität, wenn sie unbedacht eingesetzt werden. Genre, Arrangement und das Verhältnis von Gesang zu Instrumentierung geben den Korridor vor, nicht das Plugin-Preset.
Ein häufiger Fehler besteht darin, die Ratio immer weiter zu erhöhen, obwohl eigentlich der Pegel einzelner Wörter oder Silben bearbeitet werden müsste. Wenn nur zwei laute Stellen aus dem Rahmen fallen, ist eine Clip-Gain-Korrektur oder eine Automation oft die bessere Lösung. Der Kompressor muss dann nicht die komplette Performance wegen weniger Ausreißer stärker anfassen.
Wer Threshold und Ratio nicht im Verhältnis zum Material setzt, kompensiert hinterher mit der Aufholverstärkung und erzeugt damit nur ein lauteres Problem.
Gain Reduction richtig lesen
Die Anzeige der Gain Reduction ist kein Selbstzweck. Sie hilft dabei, das Verhalten des Kompressors zu beobachten, während das Ohr die klangliche Wirkung bewertet. Eine gleichmäßige Reduktion über viele Phrasen kann auf eine stabile, kontrollierte Verdichtung hindeuten. Große, hektische Ausschläge zeigen dagegen, dass der Kompressor vor allem Spitzen jagt oder mit einer zu kurzen Zeitkonstante arbeitet.
Entscheidend ist, was nach der Bearbeitung mit den leisen und lauten Passagen passiert. Werden Konsonanten unnatürlich nach vorne gezogen? Verlieren die Vokale ihre Bewegung? Wird der Atem zwischen zwei Wörtern plötzlich lauter als die Wörter selbst? Solche Hinweise sind aussagekräftiger als ein bestimmter Wert auf dem Meter.
Beim Lautstärkevergleich sollte die komprimierte Spur möglichst auf denselben wahrgenommenen Pegel wie die unbearbeitete Spur gebracht werden. Eine lautere Version wirkt fast immer zunächst besser. Erst wenn der Pegel angeglichen ist, lässt sich beurteilen, ob die Kompression tatsächlich mehr Stabilität und Charakter bringt oder nur Lautheit.
Zeitkonstanten meistern: Attack und Release für lebendige Vocals
Ein Kompressor, der nur Threshold und Ratio kennt, wäre ein stumpfes Werkzeug. Erst Attack und Release geben ihm das Timing, das eine lebendige Gesangsspur von einer gepressten Stimme unterscheidet. Diese beiden Regler entscheiden, ob die Stimme atmet oder ob sie erstickt.
Die Attack-Zeit bestimmt, wie schnell der Kompressor auf Pegelspitzen reagiert. Für Gesang liegt ein brauchbarer Ausgangsbereich häufig zwischen 3 und 10 Millisekunden. Eine kürzere Attack fängt Transienten hart ab und schiebt die Stimme in eine gleichmäßigere Position. Sie kann bei scharfen Konsonanten wie „T“, „K“ oder „P“ aber auch zu einem stumpfen Antritt führen. Bei zu aggressiver Einstellung entstehen außerdem Verzerrungen oder ein hörbares Wegknicken der Silben.
Eine längere Attack lässt die ersten Transienten durch und bewahrt den natürlichen Antritt der Stimme. Das kann besonders bei Rock-Vocals oder einer kräftigen Pop-Performance wichtig sein, weil die Stimme dadurch mehr Biss behält. Gleichzeitig steigt das Risiko, dass einzelne Laute unkontrolliert durchschlagen und im Mix für Irritationen sorgen.
Die Attack-Zeit sollte deshalb nicht isoliert auf der Vocal-Spur beurteilt werden. Eine Einstellung, die solo offen und detailreich klingt, kann in der Summe mit Bass und Schlagzeug zu spitz wirken. Umgekehrt kann eine solo etwas unspektakuläre Einstellung im Arrangement genau die nötige Präsenz liefern.
Die Release-Zeit bestimmt, wie schnell der Kompressor nach einer Spitze wieder in seinen Ausgangszustand zurückkehrt. Für Vocals bewegt man sich üblicherweise in einem weiten Bereich zwischen ungefähr 80 und 200 Millisekunden, abhängig von Tempo, Phrasierung und Kompressortyp. Eine kurze Release lässt den Kompressor schneller los und kann bei rhythmischen, perkussiven Gesangslinien mehr Bewegung erzeugen. Ist sie zu kurz, wird das Nachregeln selbst hörbar: Die Stimme beginnt zwischen den Silben zu pumpen oder die Atemzüge springen unvermittelt nach vorne.
Eine längere Release glättet die Stimme gleichmäßiger und vermeidet hektische Pegelbewegungen. Bei dichten Phrasen kann sie den Kompressor jedoch dauerhaft in der Reduktion halten. Dann steht für die nächste Silbe weniger Regelweg zur Verfügung, und der gesamte Ausdruck wirkt flacher, als wäre ein Vorhang über die Performance gelegt.
Die praktische Faustregel lautet: Die Release-Zeit sollte so kurz wie möglich sein, ohne dass Atemzüge oder Phrasenübergänge hörbar an- und abschwellen. Wer diesen Bereich findet, hat den optimalen Arbeitsbereich seines Mixes zu einem großen Teil definiert. Bei vielen Kompressoren hilft zusätzlich eine automatische Release-Funktion. Sie ersetzt die Beurteilung nicht, kann aber bei wechselnden Phrasen einen musikalischeren Verlauf liefern als ein starrer Wert.
Zeitkonstanten am Songtempo ausrichten
Attack und Release müssen nicht mathematisch auf das Tempo des Songs berechnet werden. Das Tempo liefert aber eine nützliche Orientierung. In einer schnellen, rhythmisch artikulierten Passage darf der Kompressor schneller zurückkehren, damit jede neue Silbe wieder frei reagieren kann. In einer langen Balladenphrase ist eine zu kurze Release dagegen oft deutlich hörbar, weil zwischen den Wörtern viel Raum für Pegelbewegungen liegt.
Hilfreich ist, zunächst eine bewusst deutliche Kompression einzustellen. Dann werden Attack und Release einzeln verändert, während man auf drei Dinge achtet:
1. Die Attack sollte so schnell sein, dass problematische Spitzen kontrolliert werden, aber nicht so schnell, dass der natürliche Konsonantenanschlag verschwindet.
2. Die Release sollte vor der nächsten wichtigen Silbe weitgehend zurückkehren, sofern die Stimme rhythmisch und artikuliert bleiben soll.
3. Wenn die Stimme zwischen den Wörtern unruhig atmet, ist die Release wahrscheinlich zu kurz oder die Gain Reduction zu hoch.
Danach wird die Stärke der Kompression wieder auf einen musikalisch passenden Wert zurückgenommen. Diese Reihenfolge ist oft leichter zu beurteilen, als mit einer kaum hörbaren Bearbeitung nach einem kaum hörbaren Timing-Problem zu suchen.
Serielle Kompression: Die Kombination von Spitzeneinfang und Glättung
Wer im dichten Pop- oder Rock-Mix arbeitet, stößt mit einem einzelnen Kompressor schnell an Grenzen. Die Lösung kann eine serielle Kompression sein: zwei Kompressoren hintereinander, die jeweils eine klar definierte Aufgabe übernehmen. Dieses Setup ist kein Overkill, solange beide Stufen zurückhaltend arbeiten und nicht dasselbe Problem doppelt bekämpfen.
Die erste Stufe übernimmt den Spitzeneinfang. Eine schnelle Attack, beispielsweise um 5 Millisekunden, und eine kurze Release um 40 Millisekunden können scharfe Pegelspitzen abfangen. Dazu gehören explosive Konsonanten, einzelne laute Wörter oder Schwankungen durch den Mikrofonabstand. Die Ratio darf in dieser Stufe höher ausfallen, weil der Kompressor nicht den gesamten Klangkörper formen soll. Seine Gain Reduction bleibt idealerweise moderat und bewegt sich häufig im Bereich von 2 bis 4 dB.
Die zweite Stufe übernimmt die Glättung des Gesamtkörpers. Eine etwas längere Attack zwischen etwa 8 und 15 Millisekunden lässt den natürlichen Beginn der Silben bestehen. Eine längere Release im Bereich von ungefähr 100 bis 180 Millisekunden sorgt dafür, dass die Stimme über ganze Phrasen hinweg stabil bleibt. Die Ratio kann niedriger oder mittel ausfallen. Diese Stufe formt den Charakter, bringt Kontrolle in mittlere und leisere Passagen und hält die Stimme an einer konsistenten Position im Mix.
| Parameter | Stufe 1: Spitzeneinfang | Stufe 2: Glättung |
|---|---|---|
| Attack | etwa 5 ms | etwa 8–15 ms |
| Release | etwa 40 ms | etwa 100–180 ms |
| Ratio | eher 4:1 bis 6:1 | etwa 2:1 bis 4:1 |
| Aufgabe | Spitzen und explosive Konsonanten zähmen | den Pegel über die Phrase stabilisieren |
| Gain Reduction | ungefähr 2–4 dB | ungefähr 3–6 dB |
Der Vorteil dieser Aufteilung liegt in der Hierarchie: Die erste Stufe reagiert auf kurze Ausreißer, die zweite auf den größeren Verlauf der Performance. Keine der beiden muss gleichzeitig blitzschnell und musikalisch langsam arbeiten. Die Werte in der Tabelle sind Ausgangspunkte, keine Gesetze. Sie verschieben sich je nach Sänger, Mikrofon, Aufnahmeabstand und gewünschtem Charakter.
Serielle Kompression kann allerdings auch zu viel des Guten sein. Wenn beide Geräte stark reduzieren, wird die Stimme schnell unbeweglich. Auch ein De-Esser hinter zwei Kompressoren kann problematisch werden, weil die Kompression die S-Laute bereits nach vorne gebracht hat. In vielen Fällen ist es sinnvoll, problematische Sibilanten vor der stärkeren Verdichtung zu kontrollieren und anschließend noch einmal zu prüfen, ob die Kompression neue Zischlaute hörbar gemacht hat.
Zwei moderate Kompressoren mit verschiedenen Aufgaben klingen oft kontrollierter als ein einzelner Kompressor, der alles gleichzeitig erledigen soll.
Klangcharakter durch Architektur: Opto- gegen FET-Kompressoren
Bevor man Parameter dreht, muss man wissen, mit welcher Art von Kompressor man überhaupt arbeitet. Die Architektur des Geräts bestimmt, wie Attack und Release funktionieren und welche Zahlenwerte sinnvoll greifen. Die Wahl zwischen Hardware, Nachbildung und digitalem Standardkompressor ist deshalb nicht nur eine Geschmacksfrage, sondern auch eine Entscheidung über den Arbeitsablauf.
Optische Kompressoren wie der Teletronix LA-2A arbeiten mit einer trägeren, pegelabhängigen Regelung. Bei diesem Gerät lassen sich Threshold, Ratio, Attack und Release nicht wie bei einem modernen Standardkompressor frei und unabhängig einstellen. Stattdessen wird der Arbeitsbereich im Wesentlichen über den Eingangspegel beziehungsweise die Reduktionssteuerung und die Ausgangsverstärkung bestimmt. Zusätzlich gibt es unterschiedliche Betriebsmodi für Kompression und Begrenzung. Die eigentliche Regelcharakteristik entsteht aus dem optischen Regelglied und reagiert programmabhängig auf das Signal.
Das ist der entscheidende Punkt: Ein LA-2A bietet keine frei wählbare 6:1-Kompression. Eine solche Ratio kann man ihm nicht als festen Parameter aufzwingen. Seine Verdichtung verändert sich abhängig davon, wie stark und wie lange das Signal das Regelglied anregt. Stärker komprimierte Passagen können langsamer zurückkehren, während geringere Eingriffe schneller auslaufen. Der Kompressor verhält sich damit anders als ein Gerät, bei dem Ratio, Attack und Release auf einzelne Zahlenwerte gesetzt werden.
Das Ergebnis ist eine musikalische, sanfte Verdichtung, die sich für soulige Vocals, Balladen und Passagen eignet, in denen die Stimme atmen soll. Der LA-2A ist kein Werkzeug für präzisen Spitzeneinfang im Millisekundenbereich. Seine Stärke liegt darin, den Klangkörper einer Stimme gleichmäßig nach vorne zu bringen, ohne dass jeder Regelvorgang als technischer Eingriff auffällt.
FET-Kompressoren wie der 1176 arbeiten dagegen mit sehr schnellen Reaktionszeiten und erlauben eine deutlich direktere Kontrolle. Je nach Modell oder Nachbildung stehen feste oder klar abgestufte Zeitkonstanten zur Verfügung. Sie packen schnell zu, können Transienten deutlich formen und erzeugen eine kontrollierte, präsente Stimme, die sich auch gegen dichte Arrangements behauptet. Das passt zu Rock, Pop und Produktionen, in denen die Gesangsspur bewusst an der Vorderkante des Mixes stehen soll.
FET-Kompressoren verzeihen Fehler weniger, weil sie Fehler hörbar machen. Zu viel Gain Reduction kann den Anfang von Wörtern abschneiden, Atemgeräusche hervorheben oder den oberen Mittenbereich unangenehm nach vorne rücken. Der Effekt ist nicht grundsätzlich schlecht. Aggressivität kann genau der gewünschte Charakter sein. Sie sollte nur nicht versehentlich aus einer zu hohen Eingangsverstärkung entstehen.
| Kompressortyp | Typische Stärke | Mögliche Schwäche | Geeignete Aufgabe |
|---|---|---|---|
| Opto | sanfte, programmgesteuerte Verdichtung | weniger präzise bei kurzen Spitzen | Klangkörper und längere Phrasen glätten |
| FET | schnelle Reaktion und deutliche Präsenz | kann Transienten und Atemgeräusche zu stark betonen | Spitzen kontrollieren und Vocals nach vorne bringen |
| Digitaler Standardkompressor | freie Kontrolle über alle Parameter | neutraler Klang, wenn keine Färbung gewünscht ist | präzises Arbeiten und transparente Korrekturen |
Wer parallel komprimiert und den Grundcharakter weitgehend bewahren will, kann mit einem Opto-Kompressor eine musikalische Basis schaffen. Wer eine moderne, dichte Vocal-Front baut, greift eher zu einem FET-Kompressor oder einer digitalen Nachbildung. Die Mischung beider Welten — FET für die Spitzen, Opto für die längere Glättung — ist ein klassisches Rezept in Vocal-Ketten.
Genre-spezifische Ansätze: Von sanfter Ballade bis zum dichten Pop-Mix
Die richtige Kompression hängt vom Genre ab. Nicht weil es starre Regeln gibt, sondern weil die Erwartung an eine Gesangsspur von Stil zu Stil unterschiedlich ist. Eine Ballade mit derselben Ratio und Attack zu bearbeiten wie eine moderne Pop-Hookline, kann eine Stimme erzeugen, die im Kontext des Stücks deplatziert wirkt. Genre-Logik ist kein Korsett, sondern eine Navigationshilfe.
Ballade, Akustik und Jazz
Für sanfte Balladen, akustische Produktionen und jazzige Vocals passt häufig eine niedrige Ratio zwischen 2:1 und 3:1. Eine längere Attack im Bereich von 10 bis 20 Millisekunden bewahrt den natürlichen Einsatz der Stimme. Eine längere Release kann die großen Bewegungen der Phrasen glätten, ohne dass jeder Atemzug als Pumpen hörbar wird. Eine Gain Reduction von ungefähr 3 dB ist oft ein sinnvoller Ausgangspunkt.
Hier wird komprimiert, um Pegelschwankungen auszugleichen, nicht um die Stimme in eine möglichst konstante Form zu pressen. Die leiseren Stellen dürfen ihren Abstand behalten, und ein emotionaler Anstieg sollte nicht durch eine zu schnelle Regelung eingeebnet werden. Eine Kompression, die der Sängerin oder dem Sänger die Phrasierung lässt, ist in diesem Kontext wertvoller als maximale Konsistenz.
Pop und Rock
Bei Pop- und Rock-Produktionen liegt die Ratio häufig zwischen 3:1 und 6:1. Eine Attack von etwa 3 bis 8 Millisekunden kontrolliert die Spitzen, ohne den gesamten Anschlag der Wörter zu entfernen. Die Release bewegt sich oft zwischen 80 und 150 Millisekunden, sollte aber immer auf die Phrasierung und das Tempo des Songs abgestimmt werden.
Hier zählt jede Pegelverschiebung im Verhältnis zur Gesamtenergie des Mixes. Wer zu wenig komprimiert, geht im Arrangement unter. Wer zu viel komprimiert, verliert die Spannung zwischen Strophe und Refrain. Gerade bei Rock-Vocals kann eine längere Attack mehr Biss erhalten, während eine etwas schnellere Attack bei dicht geschichteten Pop-Spuren für eine glattere Oberfläche sorgt.
R&B, Hip-Hop und EDM
Für hochverdichtete Genres wie modernen R&B, Hip-Hop oder EDM-Vocals sind höhere Ratios und schnellere Zeitkonstanten üblich. Eine Attack von etwa 3 bis 5 Millisekunden kann die Stimme eng an den Beat binden. Eine Release zwischen ungefähr 60 und 120 Millisekunden erzeugt mehr Bewegung und lässt den Kompressor rhythmisch auf die Phrase reagieren.
Die Stimme muss sich gegen Hi-Hats, Synthesizer, Subbass und stark bearbeitete Drums durchsetzen. In diesem Zusammenhang darf Kompression hörbar sein und sogar Teil des Sounds werden. Wer hier ausschließlich transparent komprimiert, erhält möglicherweise eine technisch saubere, aber im Arrangement zu weit hinten liegende Stimme. Aggressive Kontrolle ist jedoch nicht dasselbe wie blindes Niederdrücken. Auch in einem dichten Mix müssen wichtige Vokale, Endungen und emotionale Akzente erkennbar bleiben.
Der Kompressor entscheidet nicht, wie eine Stimme klingt. Er entscheidet, wie sie im Mix überlebt.
Der unbequeme Teil: Was Kompression nicht repariert
Bevor irgendein Kompressor angefasst wird, muss das Quellmaterial stehen. Ein häufiger Fehler in Hobby-Produktionen und semiprofessionellen Studios: Es wird komprimiert, um eine schlechte Aufnahme zu retten. Das funktioniert nicht. Eine Stimme mit inkonsistentem Pegel, hörbaren Sibilanten oder Raumhall-Problemen wird durch Kompression nicht sauberer, sondern nur hörbar komprimiert.
Die ehrliche Reihenfolge beginnt bei der Aufnahme: Mikrofonabstand, Raum, Vorverstärkung und die Position des Sängers bestimmen, wie viel Korrektur später nötig wird. Danach kommen Schnitt und Bearbeitung, etwa die manuelle Pegelkorrektur, ein De-Esser, eine behutsame Tonhöhenkorrektur oder das Entfernen störender Geräusche. Erst anschließend sollte die Kompression ihre eigentliche Aufgabe übernehmen.
Das bedeutet nicht, dass jede Gesangsspur vor dem Kompressor perfekt editiert sein muss. Es bedeutet, dass man unterschiedliche Probleme nicht mit demselben Werkzeug verwechselt. Ein einzelner lauter Atemzug ist kein Fall für eine deutlich höhere Ratio. Eine zu hallige Aufnahme wird nicht trocken, nur weil der Kompressor die Stimme nach vorne zieht. Und eine instabile Intonation lässt sich nicht durch mehr Gain Reduction musikalisch lösen.
Vor dem Kompressor: Pegel und S-Laute ordnen
Eine leichte manuelle Lautstärkeautomation vor dem Kompressor kann den Regelvorgang deutlich ruhiger machen. Sehr laute Wörter werden etwas zurückgenommen, leise Stellen vorsichtig angehoben. Der Kompressor muss dadurch weniger extrem arbeiten und reagiert stärker auf die musikalische Performance als auf zufällige Pegelspitzen.
Auch Sibilanten verdienen Aufmerksamkeit. Werden sie vor der Kompression nicht kontrolliert, kann der Kompressor die Zischlaute anheben und die Stimme unangenehm scharf machen. Ein De-Esser vor dem Hauptkompressor kann diese Reaktion abmildern. In anderen Fällen funktioniert ein De-Esser nach der Kompression besser, wenn die S-Laute erst durch die Verdichtung problematisch werden. Die richtige Position hängt vom Material ab; entscheidend ist, die Folge der Bearbeitung bewusst zu hören.
Wer am Ende der Vocal-Kette erneut stark komprimiert, sollte außerdem den Limiter oder Clipper auf dem Gesamtmix berücksichtigen. Die letzte Verdichtung passiert häufig nicht ausschließlich auf der Gesangsspur. Wenn die Vocal bereits massiv reduziert wurde, bevor der Mixbus arbeitet, bleibt für die Gesamtmischung weniger dynamischer Spielraum. Das kann im Refrain zunächst beeindruckend wirken, nimmt dem Song aber schnell Luft.
Position: Kompression ist Verhandlung, kein Dogma
Es gibt keine heilige Reihenfolge, keine perfekten Zahlen und kein Plugin, das den musikalischen Zusammenhang für den Menschen beurteilt. Was es gibt, sind Faustregeln, erprobte Bereiche und eine klare Hierarchie der Aufgaben:
- Der Threshold definiert, ab wann die Kompression einsetzt.
- Die Ratio bestimmt, wie stark Pegel oberhalb dieses Punktes reduziert werden.
- Die Attack formt den Anfang von Konsonanten und Vokalen.
- Die Release bestimmt, wie hörbar sich der Kompressor zwischen den Phrasen zurückbewegt.
- Die Architektur legt fest, welche Art von Regelverhalten überhaupt möglich ist.
Wer mit dieser Hierarchie arbeitet, verlässt sich nicht auf Presets, sondern auf Messwerte und das eigene Ohr im Kontext. Wer sich nur aufs Ohr verlässt, ignoriert Kennzahlen, die die Fehlersuche billiger und schneller machen können. Wer ausschließlich auf Kennzahlen setzt, baut dagegen einen Mix, der auf dem Papier stimmt und im Raum nicht funktioniert.
Die wichtigsten Vocal-Kompression-Grundlagen sind deshalb nicht einzelne Zahlen, sondern die Fähigkeit, Ursache und Wirkung auseinanderzuhalten. Ratio und Threshold bei Gesang regeln die Stärke des Eingriffs. Attack und Release für Vocals bestimmen seinen Bewegungsverlauf. Die Kompression in der Musikproduktion wird erst dann musikalisch, wenn diese Parameter nicht unabhängig voneinander, sondern als zusammenhängendes System behandelt werden.
Die richtige Kompressor-Einstellung für Vocals ist die, die zum Material passt — nicht die, die in einem Tutorial als Standard verkauft wird. Wer das versteht, hat das Handwerkszeug. Wer es im Zusammenhang mit Arrangement, Performance und Raum anwendet, hat am Ende nicht einfach eine stärker bearbeitete Stimme, sondern einen Gesangsmix, der trägt.